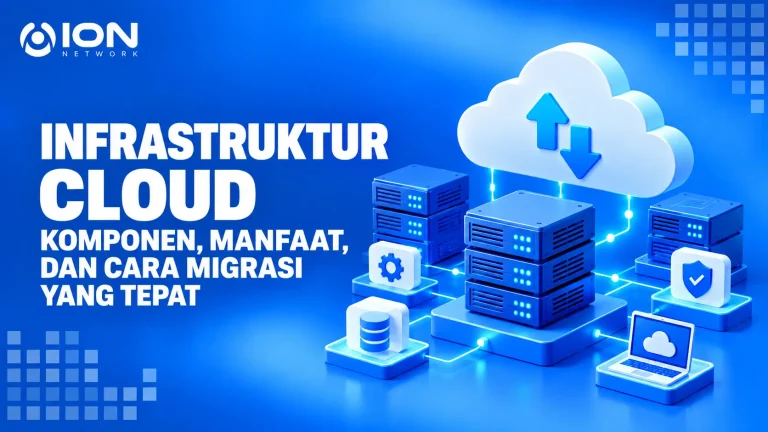

High availability cloud merupakan pendekatan dalam merancang infrastruktur cloud agar aplikasi, server, database, dan layanan digital tetap dapat diakses meskipun terjadi gangguan pada salah satu komponen. Strategi ini penting bagi bisnis yang mengandalkan layanan online untuk menjalankan transaksi, mengelola data, melayani pelanggan, hingga mendukung aktivitas operasional sehari-hari.
Dalam lingkungan bisnis yang semakin bergantung pada teknologi, downtime bukan sekadar masalah teknis. Gangguan layanan dapat menyebabkan transaksi terhenti, produktivitas menurun, pelanggan kehilangan akses, bahkan berdampak pada reputasi perusahaan. Karena itu, perusahaan membutuhkan infrastruktur yang tidak hanya memiliki performa baik, tetapi juga mampu mempertahankan ketersediaan layanan ketika terjadi kegagalan sistem.
Melalui penerapan high availability, perusahaan dapat mengurangi risiko gangguan dengan memanfaatkan server redundan, replikasi data, load balancing, failover otomatis, dan distribusi infrastruktur ke beberapa lokasi. Dengan desain yang tepat, layanan tetap dapat berjalan ketika salah satu komponen mengalami masalah tanpa harus selalu menunggu proses perbaikan selesai.
Apa Itu High Availability Cloud?
High availability atau HA adalah kemampuan suatu sistem, aplikasi, atau infrastruktur IT untuk tetap beroperasi dan dapat diakses dalam periode waktu yang panjang dengan gangguan seminimal mungkin.
Dalam konteks cloud computing, high availability cloud merupakan pendekatan arsitektur yang menggunakan beberapa komponen infrastruktur untuk menjaga layanan tetap tersedia ketika terjadi kegagalan. Komponen tersebut dapat berupa server, database, jaringan, storage, maupun layanan pendukung lainnya.
Sebagai contoh, sebuah website perusahaan menggunakan dua server aplikasi. Server pertama bertugas menangani permintaan pengguna, sedangkan server kedua berfungsi sebagai cadangan atau ikut melayani trafik. Ketika server pertama mengalami gangguan, sistem dapat mengalihkan permintaan ke server yang masih berfungsi.
Pengguna tetap dapat mengakses website tanpa harus menunggu teknisi memperbaiki server utama. Proses tersebut dapat berjalan secara otomatis apabila infrastruktur sudah dilengkapi mekanisme health check dan failover.
Menurut AWS, high availability dibangun melalui sejumlah pendekatan seperti redundancy, replication, load balancing, geographic distribution, dan failover. Tujuannya adalah mengurangi single point of failure yang dapat menyebabkan seluruh layanan berhenti ketika satu komponen mengalami masalah.
Dengan demikian, high availability bukan sekadar menyediakan server cadangan. Seluruh komponen penting dalam infrastruktur perlu dirancang agar tidak bergantung pada satu titik kegagalan.
Mengapa High Availability Penting untuk Infrastruktur Cloud?
Ketersediaan layanan menjadi salah satu faktor penting dalam pengelolaan infrastruktur digital. Website, aplikasi bisnis, sistem pembayaran, dan database perusahaan perlu dapat diakses sesuai kebutuhan pengguna.
Berikut beberapa alasan mengapa high availability penting diterapkan.
1. Mengurangi Risiko Downtime
Downtime merupakan kondisi ketika aplikasi, server, atau layanan tidak dapat digunakan untuk sementara waktu.
Gangguan dapat disebabkan oleh berbagai faktor, seperti kerusakan perangkat keras, kegagalan jaringan, kesalahan konfigurasi, lonjakan trafik, hingga masalah pada aplikasi.
Dengan arsitektur high availability, kegagalan pada satu komponen tidak harus menyebabkan seluruh layanan berhenti. Komponen lain yang masih aktif dapat mengambil alih pekerjaan sehingga dampak gangguan dapat diminimalkan.
2. Menjaga Pengalaman Pengguna
Pengguna mengharapkan layanan digital dapat diakses kapan saja. Website yang sering mengalami gangguan dapat membuat pengunjung kesulitan mendapatkan informasi atau menyelesaikan transaksi.
High availability membantu menjaga pengalaman pengguna dengan mempertahankan akses layanan ketika terjadi gangguan pada sebagian infrastruktur.
Hal ini penting terutama untuk e-commerce, aplikasi keuangan, platform pendidikan, dan layanan digital yang digunakan secara rutin.
3. Mendukung Kelangsungan Operasional Bisnis
Banyak perusahaan menjalankan aktivitas operasional melalui sistem digital. Jika aplikasi internal atau database tidak dapat diakses, pekerjaan karyawan dapat terhambat.
Penerapan high availability membantu menjaga layanan penting tetap berjalan sehingga aktivitas bisnis tidak sepenuhnya bergantung pada satu server atau pusat data.
4. Menghadapi Lonjakan Trafik
Ketika jumlah pengguna meningkat, satu server mungkin tidak mampu menangani seluruh permintaan secara optimal.
Arsitektur high availability dapat dikombinasikan dengan load balancing dan autoscaling untuk membagi beban ke beberapa server atau menambah kapasitas sesuai kebutuhan.
Dengan demikian, sistem memiliki kemampuan lebih baik dalam menghadapi peningkatan trafik.
5. Meningkatkan Kepercayaan Pelanggan
Ketersediaan layanan yang konsisten dapat meningkatkan kepercayaan pelanggan terhadap perusahaan.
Sebaliknya, gangguan yang berulang dapat memengaruhi persepsi pengguna terhadap kualitas layanan. Karena itu, high availability juga memiliki nilai bisnis, bukan hanya manfaat teknis.
Baca Juga: Infrastruktur Cloud: Komponen, Manfaat, dan Cara Migrasi yang Tepat
Bagaimana Cara Kerja High Availability Cloud?
High availability bekerja dengan menghubungkan beberapa komponen infrastruktur yang memiliki fungsi saling mendukung. Ketika salah satu komponen mengalami gangguan, sistem mendeteksi kondisi tersebut dan mengalihkan pekerjaan ke komponen lain yang masih tersedia.
Secara umum, mekanisme kerjanya dapat dijelaskan melalui beberapa tahapan berikut.
1. Permintaan Pengguna Diterima oleh Load Balancer
Ketika pengguna membuka website atau aplikasi, permintaan akan diterima oleh load balancer.
Load balancer bertugas mendistribusikan trafik ke beberapa server yang tersedia. Pembagian ini membantu menghindari penumpukan permintaan pada satu server saja.
Selain membagi trafik, load balancer dapat melakukan health check untuk mengetahui apakah server masih berfungsi dengan baik.
2. Server Memproses Permintaan
Setelah permintaan diterima, load balancer meneruskannya ke salah satu server aplikasi yang tersedia.
Dalam arsitektur dengan beberapa server, setiap instance dapat menangani permintaan pengguna sesuai kapasitas dan konfigurasi yang ditentukan.
Jika satu server mengalami gangguan, load balancer dapat berhenti mengirimkan trafik ke server tersebut.
3. Data Direplikasi ke Sistem Lain
Agar layanan tetap dapat menggunakan data yang dibutuhkan, sistem dapat menerapkan replikasi database atau storage.
Replikasi merupakan proses membuat dan memperbarui salinan data pada sistem lain. Dengan begitu, server cadangan memiliki data yang diperlukan untuk melanjutkan operasional.
Metode replikasi dapat menggunakan pendekatan sinkron maupun asinkron. Pemilihannya bergantung pada kebutuhan konsistensi data, performa, jarak antar lokasi, dan toleransi kehilangan data.
4. Sistem Mendeteksi Gangguan
Infrastruktur high availability biasanya dilengkapi monitoring dan health check untuk memantau kondisi server, aplikasi, jaringan, serta database.
Ketika sistem mendeteksi komponen yang tidak merespons atau mengalami kegagalan, mekanisme failover dapat dijalankan.
5. Failover Mengalihkan Layanan
Failover adalah proses pemindahan layanan dari komponen utama ke komponen cadangan ketika terjadi gangguan.
Sebagai contoh, ketika server utama tidak dapat digunakan, sistem akan mengalihkan permintaan ke server lain yang masih aktif.
Kecepatan perpindahan bergantung pada konfigurasi, kemampuan deteksi gangguan, kondisi replikasi data, dan desain aplikasi.
Komponen Utama dalam Arsitektur High Availability Cloud
Untuk membangun infrastruktur yang memiliki tingkat ketersediaan tinggi, terdapat beberapa komponen penting yang perlu diperhatikan.
1. Redundancy
Redundancy adalah penyediaan komponen cadangan untuk menghindari ketergantungan pada satu perangkat atau layanan.
Redundansi dapat diterapkan pada beberapa bagian infrastruktur, seperti:
- Server aplikasi.
- Database.
- Storage.
- Network interface.
- Router dan switch.
- Sumber daya listrik.
- Sistem keamanan jaringan.
Contohnya, perusahaan menggunakan dua server aplikasi dengan konfigurasi yang sama. Jika salah satunya mengalami kerusakan, server lainnya tetap dapat menjalankan aplikasi.
2. Load Balancing
Load balancing merupakan mekanisme untuk membagi permintaan pengguna ke beberapa server.
Selain membantu mengoptimalkan penggunaan resource, load balancing juga berperan dalam menjaga ketersediaan layanan.
Ketika salah satu server tidak sehat, load balancer dapat menghentikan pengiriman trafik ke server tersebut dan meneruskannya ke server lain.
3. Failover System
Failover memungkinkan sistem berpindah dari komponen utama ke komponen cadangan ketika terjadi kegagalan.
Mekanisme ini dapat berjalan otomatis atau membutuhkan tindakan administrator, tergantung pada desain infrastruktur.
Failover yang dirancang dengan baik membantu mengurangi waktu gangguan dan menjaga layanan tetap tersedia.
4. Data Replication
Data replication merupakan proses menyalin data dari satu sistem ke sistem lainnya agar informasi tetap tersedia ketika komponen utama mengalami gangguan.
Terdapat dua pendekatan umum:
Synchronous replication
Pada metode ini, perubahan data dikirim dan dikonfirmasi oleh sistem tujuan sebelum transaksi dianggap selesai. Pendekatan ini dapat memberikan konsistensi data yang lebih kuat, tetapi dapat menambah latensi, terutama jika lokasi replikasi berjauhan.
Asynchronous replication
Pada metode ini, perubahan data dikirim ke sistem tujuan setelah proses penulisan pada sistem utama. Pendekatan ini dapat memberikan performa lebih baik, tetapi terdapat kemungkinan jeda replikasi. Jika terjadi kegagalan sebelum data tersinkronisasi, sebagian perubahan terbaru mungkin belum tersedia pada sistem cadangan.
Pemilihan metode perlu mempertimbangkan kebutuhan aplikasi, karakteristik transaksi, dan toleransi kehilangan data.
5. Monitoring dan Health Check
Monitoring membantu administrator mengetahui kondisi infrastruktur secara berkelanjutan.
Beberapa metrik yang dapat dipantau meliputi:
- Penggunaan CPU dan RAM.
- Ketersediaan server.
- Penggunaan storage.
- Latensi jaringan.
- Respons aplikasi.
- Status database.
- Keterlambatan replikasi.
- Jumlah error dan permintaan gagal.
Health check digunakan untuk memastikan komponen masih berfungsi. Informasi tersebut dapat menjadi dasar bagi load balancer atau sistem failover untuk menentukan apakah sebuah server layak menerima trafik.
6. Availability Zone
Availability Zone (AZ) adalah lokasi pusat data yang terisolasi secara fisik di dalam suatu cloud region. Setiap zona dirancang memiliki infrastruktur pendukung yang independen, termasuk daya, pendinginan, dan jaringan.
Dengan mendistribusikan workload ke beberapa Availability Zone, perusahaan dapat mengurangi risiko gangguan yang berasal dari satu lokasi pusat data.
Misalnya, aplikasi ditempatkan pada AZ A dan AZ B. Jika terjadi gangguan pada AZ A, layanan dapat dialihkan ke AZ B selama komponen aplikasi, jaringan, dan data telah disiapkan untuk mendukung failover.
Apa Itu Availability Zone dan Hubungannya dengan High Availability?
Availability Zone merupakan salah satu pendekatan penting untuk membangun high availability cloud, khususnya ketika perusahaan ingin mengurangi risiko kegagalan pada tingkat pusat data.
Untuk memahaminya, perlu diketahui perbedaan antara region dan Availability Zone.
Region merupakan area geografis tempat penyedia cloud mengoperasikan infrastrukturnya. Sementara itu, Availability Zone adalah lokasi pusat data atau kelompok pusat data yang berada di dalam suatu region.
Satu region dapat memiliki satu atau beberapa Availability Zone, bergantung pada desain infrastruktur penyedia cloud.
| Aspek | Region | Availability Zone |
|---|---|---|
| Pengertian | Area geografis infrastruktur cloud | Lokasi pusat data terisolasi dalam region |
| Cakupan | Lebih luas | Lebih spesifik |
| Tujuan | Menentukan lokasi layanan dan infrastruktur | Mengurangi dampak kegagalan lokal |
| Contoh penggunaan | Penempatan workload di Jakarta atau Singapura | Distribusi server di beberapa zona dalam region |
Menurut panduan Biznet Gio, Availability Zone dirancang dengan redundansi daya, pendinginan, dan jaringan agar kegagalan pada satu zona tidak langsung mengganggu zona lainnya dalam region yang sama.
Single-AZ vs Multi-AZ
Dalam implementasi cloud, perusahaan dapat memilih menggunakan satu atau beberapa Availability Zone.
| Aspek | Single-AZ | Multi-AZ |
|---|---|---|
| Penempatan workload | Satu zona | Dua atau lebih zona |
| Redundansi lokasi | Terbatas pada satu zona | Tersebar di beberapa zona |
| Risiko gangguan lokal | Lebih tinggi | Lebih rendah jika dirancang dengan benar |
| Kompleksitas | Relatif sederhana | Lebih kompleks |
| Biaya | Dapat lebih rendah | Umumnya membutuhkan resource tambahan |
| Kebutuhan | Workload nonkritis | Workload yang membutuhkan ketersediaan tinggi |
Single-AZ dapat digunakan untuk aplikasi development, pengujian, atau workload yang masih dapat mentoleransi downtime.
Sementara itu, Multi-AZ lebih sesuai untuk aplikasi penting seperti sistem transaksi, layanan pelanggan, platform e-commerce, dan aplikasi bisnis yang membutuhkan ketersediaan lebih tinggi.
Namun, penggunaan Multi-AZ tidak otomatis menjamin layanan bebas gangguan. Perusahaan tetap perlu menyiapkan replikasi data, load balancing, monitoring, dan mekanisme failover yang sesuai.
Jenis Arsitektur High Availability Cloud
Terdapat beberapa pendekatan arsitektur yang dapat digunakan untuk membangun sistem high availability. Dua pola yang umum digunakan adalah active-active dan active-passive.
1. Active-Active Architecture
Active-active merupakan arsitektur yang menggunakan dua atau lebih server atau node aktif secara bersamaan untuk menangani permintaan pengguna.
Setiap node dapat menerima dan memproses trafik sesuai pembagian yang dilakukan oleh load balancer.
Jika salah satu node mengalami gangguan, node lain yang masih aktif dapat mengambil alih sebagian atau seluruh beban kerja.
Kelebihan active-active:
- Resource digunakan secara bersamaan.
- Kapasitas layanan dapat lebih besar.
- Tidak sepenuhnya bergantung pada satu server utama.
- Mendukung distribusi trafik dan skalabilitas.
Kekurangan active-active:
- Konfigurasi lebih kompleks.
- Membutuhkan pengelolaan konsistensi data.
- Biaya infrastruktur dapat lebih tinggi.
- Memerlukan pengujian untuk menghindari konflik data dan kegagalan berantai.
Arsitektur ini cocok untuk layanan dengan trafik tinggi dan kebutuhan ketersediaan yang ketat.
2. Active-Passive Architecture
Active-passive menggunakan satu sistem utama yang aktif menangani permintaan, sedangkan sistem lainnya berada dalam kondisi standby.
Sistem cadangan dapat menerima replikasi data dari server utama. Ketika server utama mengalami gangguan, sistem standby akan mengambil alih operasional melalui mekanisme failover.
Kelebihan active-passive:
- Konsep implementasi relatif lebih sederhana.
- Sistem cadangan tidak harus melayani trafik secara bersamaan.
- Dapat menjadi pilihan untuk menekan biaya dibandingkan active-active.
- Cocok untuk layanan yang membutuhkan sistem cadangan.
Kekurangan active-passive:
- Resource cadangan mungkin tidak digunakan secara optimal.
- Perpindahan layanan dapat membutuhkan waktu.
- Replikasi data perlu dipastikan berjalan dengan baik.
- Sistem standby harus diuji secara berkala.
Arsitektur ini dapat digunakan untuk aplikasi bisnis yang membutuhkan perlindungan terhadap kegagalan server, tetapi tidak memerlukan semua node aktif secara bersamaan.
Cara Mengukur High Availability dengan Uptime
Salah satu cara untuk mengukur ketersediaan sistem adalah melalui persentase uptime. Uptime menunjukkan persentase waktu ketika layanan dapat digunakan dalam periode tertentu.
Dalam industri cloud, target ketersediaan sering dinyatakan menggunakan istilah nines, seperti 99%, 99,9%, 99,99%, dan 99,999%.
Semakin banyak angka sembilan, semakin kecil toleransi downtime yang ditargetkan.
Berikut ilustrasi perkiraan downtime maksimum berdasarkan target uptime selama satu tahun dengan asumsi 365 hari.
| Target Uptime | Perkiraan Downtime per Tahun |
|---|---|
| 99% | 3 hari 15 jam 36 menit |
| 99,9% | 8 jam 45 menit 36 detik |
| 99,99% | 52 menit 34 detik |
| 99,999% | 5 menit 15 detik |
Sebagai contoh, layanan dengan target uptime 99,9% memiliki toleransi downtime sekitar 8 jam 45 menit dalam satu tahun.
Sementara itu, target 99,99% menurunkan perkiraan downtime menjadi sekitar 52 menit per tahun.
Perlu diperhatikan bahwa angka tersebut merupakan ilustrasi matematis. Perhitungan SLA penyedia cloud dapat menggunakan periode pengukuran, pengecualian maintenance, dan ketentuan layanan yang berbeda.
Rumus Menghitung Availability
Availability dapat dihitung menggunakan rumus berikut:
Availability = (Total Uptime / Total Waktu Pengamatan) × 100%
Contohnya, sebuah aplikasi beroperasi selama 30 hari atau 720 jam. Dalam periode tersebut, aplikasi mengalami downtime selama 2 jam.
Maka perhitungannya:
Availability = ((720 – 2) / 720) × 100%
Availability = 99,72%
Artinya, aplikasi memiliki tingkat ketersediaan sekitar 99,72% selama periode pengamatan tersebut.
Selain uptime, terdapat metrik lain yang digunakan untuk mengevaluasi keandalan sistem.
- MTBF (Mean Time Between Failures): Rata-rata waktu operasional antara satu kegagalan dan kegagalan berikutnya.
- MTTR (Mean Time to Repair): Rata-rata waktu yang dibutuhkan untuk memperbaiki sistem setelah terjadi gangguan.
- MTTD (Mean Time to Detect): Rata-rata waktu yang dibutuhkan untuk mendeteksi suatu gangguan.
Secara umum, ketersediaan dapat ditingkatkan dengan mengurangi frekuensi kegagalan dan mempercepat proses pemulihan.
Perbedaan High Availability dan Disaster Recovery
High Availability dan Disaster Recovery sering dianggap sebagai konsep yang sama karena keduanya berhubungan dengan kelangsungan layanan. Padahal, keduanya memiliki tujuan dan cakupan yang berbeda.
High Availability berfokus pada menjaga layanan tetap berjalan ketika terjadi kegagalan pada komponen infrastruktur. Sementara itu, Disaster Recovery berfokus pada pemulihan sistem setelah terjadi gangguan besar yang menyebabkan layanan tidak dapat beroperasi.
| Aspek | High Availability | Disaster Recovery |
|---|---|---|
| Fokus | Menjaga layanan tetap tersedia | Memulihkan layanan setelah bencana |
| Tujuan | Meminimalkan downtime | Mengembalikan operasional |
| Pendekatan | Redundancy, failover, load balancing, replication | Backup, restore, replication, recovery plan |
| Pemicu | Kegagalan server, jaringan, atau komponen aplikasi | Bencana besar, kerusakan data, atau gangguan regional |
| Lokasi | Umumnya dalam satu region atau beberapa zona | Sering melibatkan lokasi atau region berbeda |
| Hasil yang diharapkan | Layanan tetap berjalan atau mengalami gangguan minimal | Layanan kembali beroperasi sesuai target pemulihan |
Ada dua metrik penting dalam perencanaan Disaster Recovery.
RTO (Recovery Time Objective) adalah batas waktu maksimal yang dapat diterima perusahaan untuk memulihkan layanan setelah gangguan.
RPO (Recovery Point Objective) adalah batas maksimal kehilangan data yang masih dapat ditoleransi, biasanya diukur berdasarkan waktu sejak data terakhir berhasil dipulihkan.
Sebagai contoh, perusahaan menetapkan RTO selama satu jam dan RPO selama 15 menit. Artinya, perusahaan menargetkan layanan kembali berjalan maksimal satu jam setelah insiden dan kehilangan data tidak melebihi perubahan dalam rentang 15 menit terakhir.
High Availability tidak menggantikan Disaster Recovery. Keduanya justru perlu dirancang secara bersamaan untuk melindungi layanan dari kegagalan lokal maupun bencana yang lebih besar.
Strategi Menerapkan High Availability Cloud
Membangun arsitektur high availability membutuhkan perencanaan yang sesuai dengan karakteristik aplikasi dan kebutuhan bisnis. Tidak semua sistem membutuhkan arsitektur yang sama karena setiap workload memiliki toleransi downtime, kebutuhan data, dan anggaran yang berbeda.
Berikut beberapa strategi yang dapat diterapkan.
1. Identifikasi Single Point of Failure
Langkah pertama adalah mengidentifikasi komponen yang dapat menyebabkan seluruh layanan berhenti ketika mengalami kegagalan.
Contohnya, aplikasi menggunakan dua server, tetapi keduanya masih bergantung pada satu database tanpa replikasi. Jika database tersebut mengalami gangguan, seluruh aplikasi tetap tidak dapat berfungsi.
Karena itu, pemeriksaan perlu mencakup server, database, storage, jaringan, DNS, hingga sistem autentikasi.
2. Gunakan Redundansi pada Komponen Kritis
Sediakan komponen cadangan untuk bagian infrastruktur yang paling penting.
Redundansi dapat diterapkan pada server aplikasi, database, storage, dan jaringan. Tujuannya agar layanan tidak bergantung pada satu perangkat atau satu jalur koneksi.
3. Distribusikan Workload ke Beberapa Availability Zone
Jika penyedia cloud mendukung Availability Zone, pertimbangkan untuk menempatkan komponen aplikasi pada zona yang berbeda.
Distribusi ini membantu mengurangi risiko gangguan yang berasal dari satu lokasi pusat data.
Namun, pastikan komunikasi antarzona, replikasi data, dan mekanisme failover sudah dirancang dengan benar.
4. Terapkan Load Balancing dan Failover Otomatis
Gunakan load balancer untuk membagi trafik ke beberapa server dan melakukan health check secara berkala.
Konfigurasikan mekanisme failover agar permintaan pengguna dapat dialihkan ke server yang masih sehat ketika terjadi gangguan.
5. Rancang Replikasi dan Perlindungan Data
Pastikan data penting memiliki strategi replikasi dan backup yang sesuai.
Replikasi membantu menyediakan salinan data untuk kebutuhan operasional ketika terjadi kegagalan komponen. Sementara itu, backup diperlukan untuk memulihkan data ketika terjadi penghapusan, kerusakan, atau insiden yang tidak dapat diselesaikan hanya dengan failover.
6. Lakukan Monitoring dan Alerting
Monitoring perlu mencakup seluruh komponen yang memengaruhi ketersediaan layanan.
Buat sistem peringatan agar tim teknis dapat segera mengetahui ketika terjadi peningkatan error, penurunan performa, server tidak merespons, atau replikasi mengalami keterlambatan.
7. Uji Mekanisme Failover Secara Berkala
Failover yang terlihat baik dalam konfigurasi belum tentu berjalan sesuai harapan ketika terjadi gangguan sebenarnya.
Lakukan pengujian untuk memastikan server cadangan dapat mengambil alih pekerjaan, data tetap konsisten, dan aplikasi dapat digunakan kembali.
Pengujian juga perlu mencakup proses failback, yaitu mengembalikan layanan ke sistem utama setelah gangguan selesai ditangani.
8. Sesuaikan Arsitektur dengan Anggaran
Semakin tinggi target availability, biasanya semakin besar kebutuhan resource dan kompleksitas operasional.
Perusahaan perlu menentukan sistem mana yang benar-benar membutuhkan ketersediaan tinggi. Dengan begitu, investasi dapat diprioritaskan pada aplikasi dan layanan yang memiliki dampak paling besar terhadap bisnis.
Tantangan dalam Menerapkan High Availability Cloud
Meskipun memberikan banyak manfaat, penerapan high availability juga memiliki sejumlah tantangan.
1. Biaya Infrastruktur Lebih Tinggi
Penggunaan beberapa server, database cadangan, storage tambahan, dan layanan load balancing dapat meningkatkan biaya operasional.
Perusahaan perlu memperhitungkan biaya resource, transfer data, monitoring, serta layanan pendukung lainnya.
2. Kompleksitas Pengelolaan
Arsitektur dengan beberapa server dan zona membutuhkan konfigurasi yang lebih kompleks dibandingkan sistem dengan satu server.
Tim IT perlu memahami cara kerja replikasi, failover, load balancing, jaringan, dan pengelolaan data agar tidak menimbulkan masalah baru.
3. Konsistensi Data
Replikasi data perlu dikelola dengan benar agar sistem utama dan cadangan tidak memiliki perbedaan informasi yang dapat mengganggu operasional.
Dalam sistem terdistribusi, perusahaan juga perlu memperhatikan risiko seperti konflik penulisan, keterlambatan replikasi, dan split-brain.
4. Latensi Antarserver dan Zona
Distribusi workload ke beberapa lokasi dapat menambah latensi komunikasi, terutama ketika aplikasi sering melakukan pertukaran data antarserver.
Karena itu, penempatan aplikasi dan database perlu mempertimbangkan pola komunikasi serta kebutuhan performa.
5. Pengujian dan Pemeliharaan
High availability bukan sistem yang cukup dikonfigurasi satu kali lalu dibiarkan berjalan.
Pembaruan aplikasi, perubahan konfigurasi, patch keamanan, dan perubahan infrastruktur perlu dikelola secara terencana agar tidak menyebabkan gangguan pada komponen yang sedang aktif.
Contoh Penerapan High Availability Cloud
Untuk memahami penerapannya, bayangkan sebuah perusahaan e-commerce memiliki website yang digunakan pelanggan untuk mencari produk, melakukan pembayaran, dan memeriksa status pesanan.
Jika seluruh aplikasi hanya berjalan pada satu server, kerusakan server tersebut dapat membuat website tidak dapat diakses.
Dengan menerapkan high availability, perusahaan dapat menggunakan beberapa komponen berikut:
- Load balancer: Menerima dan membagi trafik pengguna ke beberapa server aplikasi.
- Server aplikasi A dan B: Menjalankan aplikasi secara bersamaan atau menggunakan salah satunya sebagai cadangan.
- Database utama dan replika: Menyediakan salinan data sesuai metode replikasi yang digunakan.
- Monitoring: Memantau kondisi server, database, dan jaringan.
- Failover: Mengalihkan layanan ketika salah satu komponen mengalami gangguan.
- Backup: Menyediakan salinan data untuk pemulihan ketika terjadi kerusakan atau kehilangan data.
Jika server aplikasi A mengalami gangguan, load balancer dapat mengalihkan permintaan ke server B. Jika database utama mengalami kegagalan, mekanisme failover database dapat mengalihkan operasional ke replika yang telah disiapkan.
Dengan desain tersebut, perusahaan tidak harus selalu menghentikan seluruh layanan hanya karena satu komponen mengalami masalah.
Namun, keberhasilan penerapan tetap bergantung pada pengujian, konsistensi data, dan kesiapan setiap komponen dalam mengambil alih fungsi sistem yang gagal.
Baca Juga: Cloud Cost Optimization: Strategi Efektif Menghemat Biaya Cloud Hingga 40%
Kesimpulan
High availability cloud merupakan pendekatan penting untuk menjaga aplikasi, server, database, dan layanan digital tetap dapat diakses ketika terjadi gangguan pada infrastruktur. Dengan memanfaatkan redundancy, load balancing, failover, data replication, monitoring, serta distribusi workload ke beberapa Availability Zone, perusahaan dapat mengurangi risiko downtime dan meningkatkan keandalan layanan.
Namun, high availability bukan berarti sistem tidak mungkin mengalami gangguan. Arsitektur ini dirancang untuk mengurangi dampak kegagalan dan mempercepat perpindahan layanan ke komponen yang masih berfungsi. Karena itu, implementasinya tetap membutuhkan perencanaan, pengujian, pemeliharaan, dan pengelolaan data yang tepat.
Perusahaan juga perlu membedakan High Availability dengan Disaster Recovery. High Availability membantu menjaga layanan tetap berjalan ketika komponen mengalami kegagalan, sedangkan Disaster Recovery mempersiapkan proses pemulihan ketika terjadi insiden besar yang melampaui kemampuan arsitektur HA.
Pada akhirnya, infrastruktur cloud yang andal bukan hanya tentang menyediakan banyak server atau resource yang besar. Hal terpenting adalah memastikan setiap komponen memiliki fungsi yang jelas, tidak menciptakan single point of failure, dan mampu mendukung kebutuhan operasional bisnis dengan tingkat ketersediaan yang sesuai.
Butuh cloud lokal yang terjangkau untuk membangun infrastruktur dengan ketersediaan tinggi? Paket cloud mulai dari Rp165 ribuan sudah termasuk Intel Processor, hingga 4 Core CPU, hingga 4 GB RAM, dan hingga 100 GB Storage, serta tersedia opsi custom resource sesuai kebutuhan workload. Dengan dukungan resource yang fleksibel, Anda dapat menyiapkan infrastruktur untuk menjalankan aplikasi, mengelola server cadangan, dan mengembangkan arsitektur High Availability Cloud sesuai kebutuhan bisnis. Pastikan konfigurasi server, replikasi data, monitoring, dan mekanisme failover dirancang dengan tepat agar layanan tetap tersedia ketika terjadi gangguan.
FAQ
High availability cloud adalah pendekatan arsitektur cloud yang dirancang untuk menjaga aplikasi, server, database, dan layanan tetap tersedia meskipun terjadi kegagalan pada sebagian komponen infrastruktur.
Tujuan utamanya adalah mengurangi downtime, menghindari single point of failure, menjaga layanan tetap dapat diakses, dan mendukung kelangsungan operasional bisnis.
Komponen utamanya meliputi redundancy, load balancing, failover, data replication, monitoring, health check, dan Availability Zone.
High Availability berfokus pada menjaga layanan tetap berjalan ketika terjadi kegagalan komponen. Disaster Recovery berfokus pada pemulihan sistem setelah gangguan besar atau bencana yang menyebabkan layanan berhenti.
Availability Zone adalah lokasi pusat data yang terisolasi secara fisik di dalam suatu region cloud. Penggunaan beberapa zona memungkinkan workload didistribusikan untuk mengurangi risiko gangguan pada satu lokasi.
Active-active menggunakan beberapa node yang aktif secara bersamaan untuk menangani permintaan. Sementara itu, active-passive menggunakan satu node utama dan node lain sebagai sistem cadangan yang mengambil alih ketika terjadi kegagalan.
Tidak. High availability membantu meningkatkan ketersediaan layanan dan mengurangi downtime, tetapi tidak menjamin uptime 100%. Kegagalan aplikasi, kesalahan konfigurasi, gangguan jaringan, dan insiden besar tetap dapat memengaruhi layanan.
Target uptime bergantung pada kebutuhan aplikasi dan bisnis. Target 99,9% dapat menjadi acuan awal bagi banyak layanan, sedangkan aplikasi yang lebih kritis mungkin membutuhkan target 99,99% atau lebih tinggi. Penetapan target perlu mempertimbangkan biaya, risiko, dan ketentuan SLA penyedia cloud.
Umumnya, arsitektur HA membutuhkan lebih dari satu instance atau komponen redundan untuk menghindari ketergantungan pada satu titik kegagalan. Namun, jumlah dan jenis komponen yang dibutuhkan bergantung pada desain sistem.
Belum. Backup berfungsi untuk memulihkan data ketika terjadi kehilangan atau kerusakan, sedangkan high availability bertujuan menjaga layanan tetap berjalan ketika komponen mengalami kegagalan. Keduanya saling melengkapi dan sebaiknya diterapkan sesuai kebutuhan bisnis.